科技 · 實用指南
將 Audacity 頻譜標籤轉為 CSV,避免頻率與標籤錯位
把頻率續行配到對應標籤,保留原秒數文字,並區分頻率紀錄缺失、邊界未定義和真正的零赫茲。
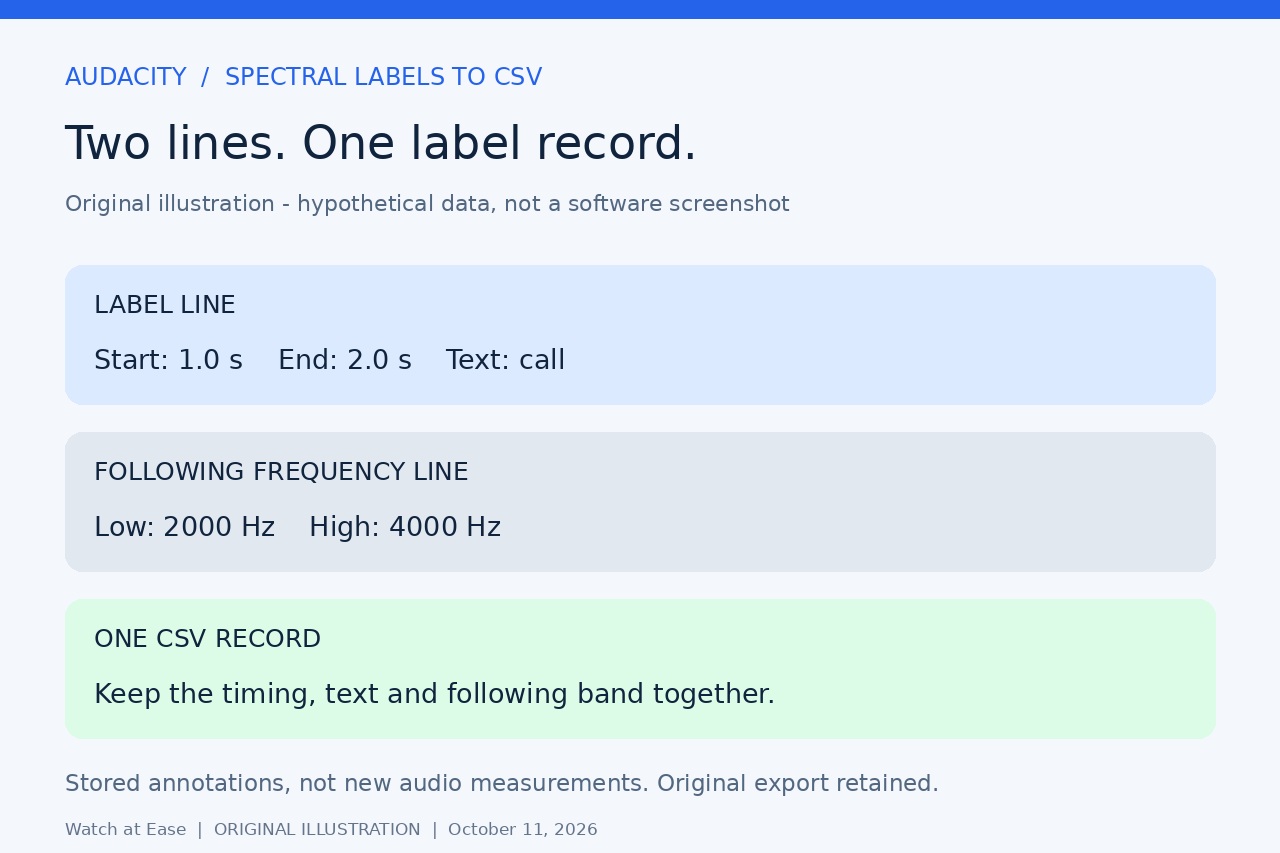
頻譜標籤匯出不一定是一條標籤對應一列試算表。Audacity 擴充文字格式把時間與標籤文字寫在一行,已存頻率範圍寫在下一條以反斜線開頭的續行。把每行都當成新標籤會破壞配對。
原生擴充匯出已能保留頻率。本指南補充離線 CSV 轉換,適用於自己產生的受支援 UTF-8 文字,並檢查配對、保留原數字文字;它不分析音訊,也不能恢復匯出中缺失的頻率。
匯出正確文字,核對範圍
保留專案和原標籤文字。選擇純文字標籤匯出,不選 SRT、WebVTT 或音訊匯出。你的版本若提供「匯出標籤樣式」,選擇帶頻率範圍的擴充格式。檢查已知頻譜標籤:時間與文字行後應接反斜線、定位字元、低頻值、定位字元、高頻值。各版選單用詞不同;我們未執行目前介面。
核對匯出包含哪些標籤軌。目前標籤軌手冊說明可從某條軌的選單匯出該軌,目前原始匯出模型也支援選擇軌道。舊文件曾描述合併各軌。不要為遵循過時方法而刪除軌道。需要軌道歸屬時分別匯出,並在 CSV 外記錄專案、軌道、版本及日期。
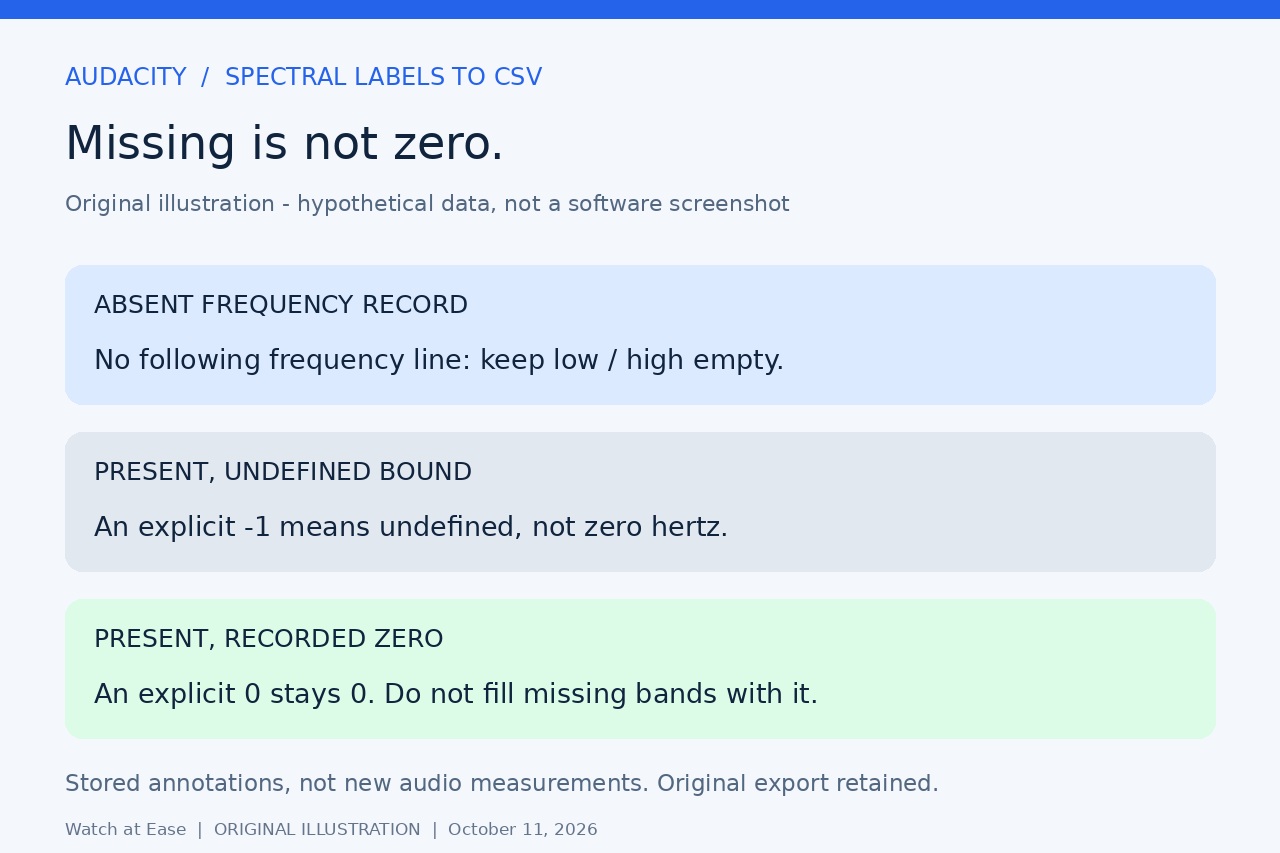
沒有頻率續行不等於零赫茲:可能使用標準匯出樣式,也可能本來未儲存頻率範圍。擴充格式中的 -1 表示該邊界未定義。必要時檢查原標籤並重新匯出;轉換不能推斷缺失範圍,也不能重建文字中沒有的軌道名稱。
用 Python 3 轉換受支援副本
此方法接收兩個以定位字元分隔的非負開始/結束秒數、可選標籤文字及最多一條緊隨其後的頻率續行。支援小數點數字、有限非負頻率或未定義標記 -1。負時間標籤、逗號小數、空紀錄、多餘定位字元欄位或未來新增續行格式均不在範圍內,建立輸出前就會停止。
在安裝 Python 3 的 Linux Bash 終端機,進入自己 labels.txt 副本所在目錄。把以下命令按一行複製,保留直引號與反斜線。保留輸入名,換用新輸出名;已有 labels.csv 會被拒絕。這條準確命令只在 Linux Bash 測試,未在 Windows/macOS 測試。
python3 -c 'exec('"'"'import csv\nfrom decimal import Decimal\nimport pathlib\nimport re\nimport sys\n\ndef number(text, minimum):\n if not re.fullmatch(r"[+-]?[0-9]+(?:\\.[0-9]*)?(?:[eE][+-]?[0-9]+)?", text):\n raise ValueError("Expected an unpadded dot-decimal number")\n value = Decimal(text)\n if not value.is_finite() or value < minimum:\n raise ValueError("Unsupported numerical value")\n return value\n\nrows = []\nraw = pathlib.Path(sys.argv[1]).read_text(encoding="utf-8-sig")\nlines = raw.split("\\n")\nif lines[-1] == "":\n lines.pop()\nfor line in lines:\n fields = line.split("\\t")\n if fields[0] == "\\\\":\n if len(fields) != 3 or not rows or rows[-1][-1] != "absent":\n raise ValueError("Orphan, repeated or unsupported frequency line")\n low, high = [number(text, Decimal(-1)) for text in fields[1:]]\n if any(value < 0 and value != -1 for value in [low, high]):\n raise ValueError("Negative frequency must be the undefined -1 sentinel")\n if low >= 0 and high >= 0 and low > high:\n raise ValueError("Reversed frequency bounds")\n rows[-1][4:] = [fields[1], fields[2], "present"]\n else:\n if len(fields) not in [2, 3]:\n raise ValueError("Expected two times and optional label, tab separated")\n start, end = [number(text, Decimal(0)) for text in fields[:2]]\n if end < start:\n raise ValueError("Reversed time bounds")\n rows.append([str(len(rows) + 1), fields[0], fields[1], fields[2] if len(fields) == 3 else "", "", "", "absent"])\nif not rows:\n raise ValueError("No label records")\nheader = ["ordinal", "start_seconds", "end_seconds", "label", "low_hz", "high_hz", "frequency_record"]\nwith open(sys.argv[2], "x", encoding="utf-8-sig", newline="") as output:\n writer = csv.writer(output)\n writer.writerow(header)\n writer.writerows(rows)\nwith open(sys.argv[2], encoding="utf-8-sig", newline="") as output:\n if list(csv.reader(output)) != [header] + rows:\n raise ValueError("Readback differs; discard output and use a new name")\nprint(len(rows), "label records checked; missing frequency is not zero")\n'"'"')' "labels.txt" "labels.csv"
閱讀七欄,保留各自含義
CSV 七欄為 ordinal、start_seconds、end_seconds、label、low_hz、high_hz、frequency_record。ordinal 按輸入順序從 1 開始,不是軌道號。present 表示解析了實際頻率續行;absent 表示兩頻率儲存格留空。明確的 -1 保留原文字,不改成零或猜測的邊界。
轉換器保留標籤文字、重複紀錄、輸入順序及原數字字串。Decimal 只用於檢查邊界,不進行浮點捨入、時長計算、排序或頻率估計。CSV 引號處理標籤中的逗號與雙引號。輸出回讀後逐欄位與已解析紀錄比較,通過後才印出成功。
LibreOffice Calc 匯入選擇 UTF-8、逗號分隔及直雙引號文字分隔符號。七欄均設為「文字」,關閉「合併分隔符號」「修剪空格」「計算公式」。對話框被隱藏時啟用「編輯篩選器設定」。保留未改 CSV 主副本;數值計算前另建工作副本,並在其中選擇正確小數語言區域。
核對配對,棄用不完整結果
把印出的標籤數與預期匯出對照,不與實體行數對照:頻率續行不是另一個標籤。檢查已知點標籤、區域標籤及單邊未定義標籤,特別核對缺失頻帶附近紀錄,避免後一個頻率錯接到其他標籤。多個軌合併匯出可能已丟失歸屬;此 CSV 不會恢復它。
我們用這條準確命令執行 23 項模擬案例,涵蓋點/區域配對、缺失與零、-1 邊界、長數字文字、Unicode 和標點、重複空標籤及 UTF-8 BOM/CRLF。六項有效案例又驗證重複寫入被拒絕且輸出不變,輸入位元組保持不變。未執行 Audacity 或 Calc,也未在 Windows/macOS 執行此命令。
錯誤或孤立頻率行、重複續行、邊界倒置及不支援紀錄會在建立輸出前停止。寫入或回讀失敗時,棄用不完整 CSV,換新名稱重跑。保留原文字作對照。此表記錄已匯出選取,不是峰值、振幅、物種辨識或已完成音訊匯出;頻率範圍是儲存的標註,不是新做的頻譜測量。