Tecnología · GUÍA PRÁCTICA
Convierte etiquetas espectrales de Audacity a CSV sin desalinear frecuencias
Une cada línea de frecuencia a su etiqueta, conserva los segundos originales y distingue un registro ausente, límites indefinidos y cero hercios real.
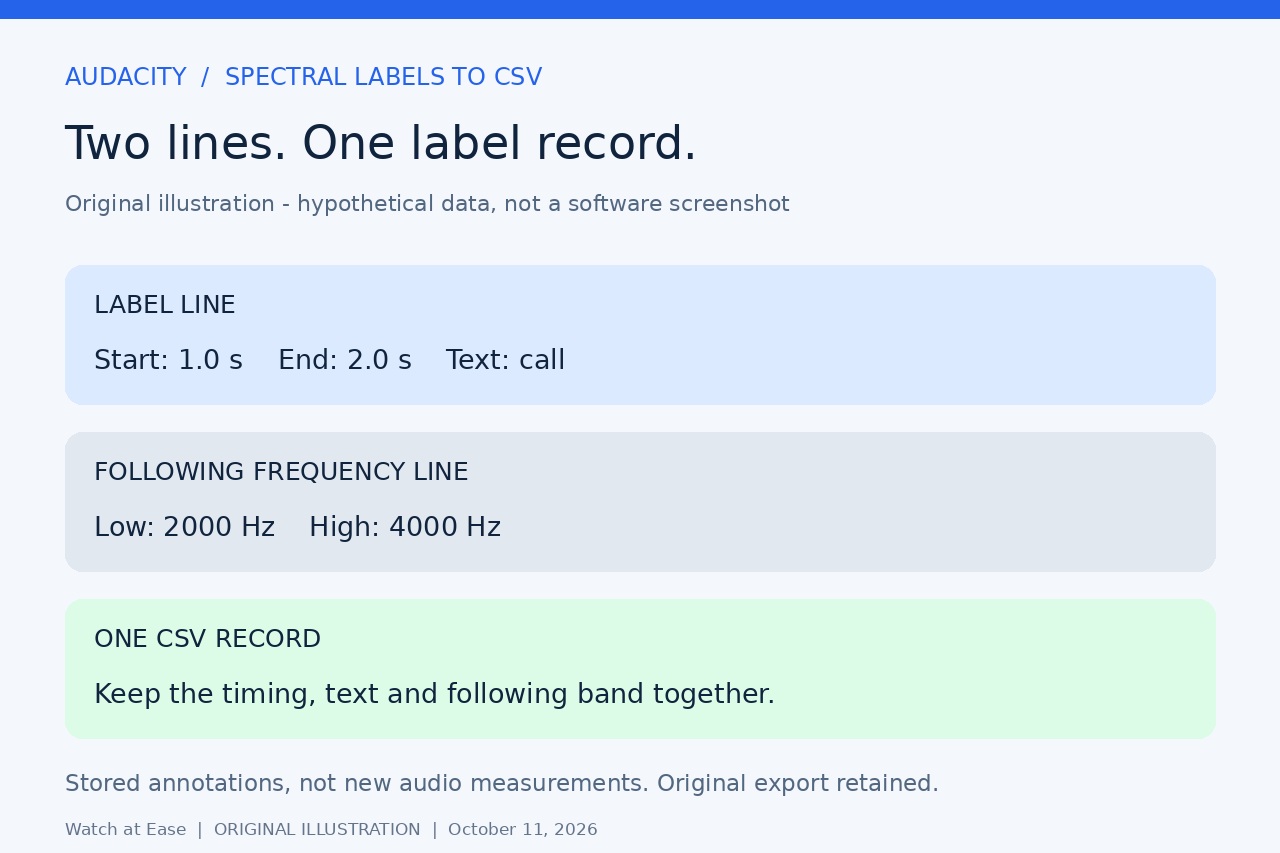
Una exportación de etiquetas espectrales no siempre produce una fila por etiqueta. En el texto extendido de Audacity, tiempos y texto ocupan una línea; el rango de frecuencia guardado va en otra que empieza con una barra inversa. Tratar cada línea como una etiqueta rompe esa relación.
La exportación extendida nativa ya conserva las frecuencias. Aquí añadimos una conversión acotada y sin conexión de tu propio texto UTF-8 compatible, con emparejamiento comprobado y cadenas numéricas intactas. No analiza audio ni recupera frecuencias ausentes del archivo.
Exporta el texto correcto y comprueba su alcance
Conserva el proyecto y el texto original. Elige exportar etiquetas como texto sencillo, no SRT, WebVTT ni audio. Si tu versión ofrece Exported Label Style, selecciona Extended con rangos de frecuencia. Revisa una etiqueta espectral conocida: tras la línea de tiempo/texto deben aparecer barra inversa, tabulador, frecuencia baja, tabulador y frecuencia alta. Los menús cambian entre versiones; no ejecutamos la interfaz actual.
Comprueba qué pistas de etiquetas incluye. El manual actual documenta exportar una pista desde su propio menú y el modelo original de exportación actual admite seleccionar pistas. La documentación antigua describe combinarlas. No borres pistas para seguir una solución obsoleta. Exporta por separado si necesitas atribución de pista y anota proyecto, pista, versión y fecha fuera del CSV.
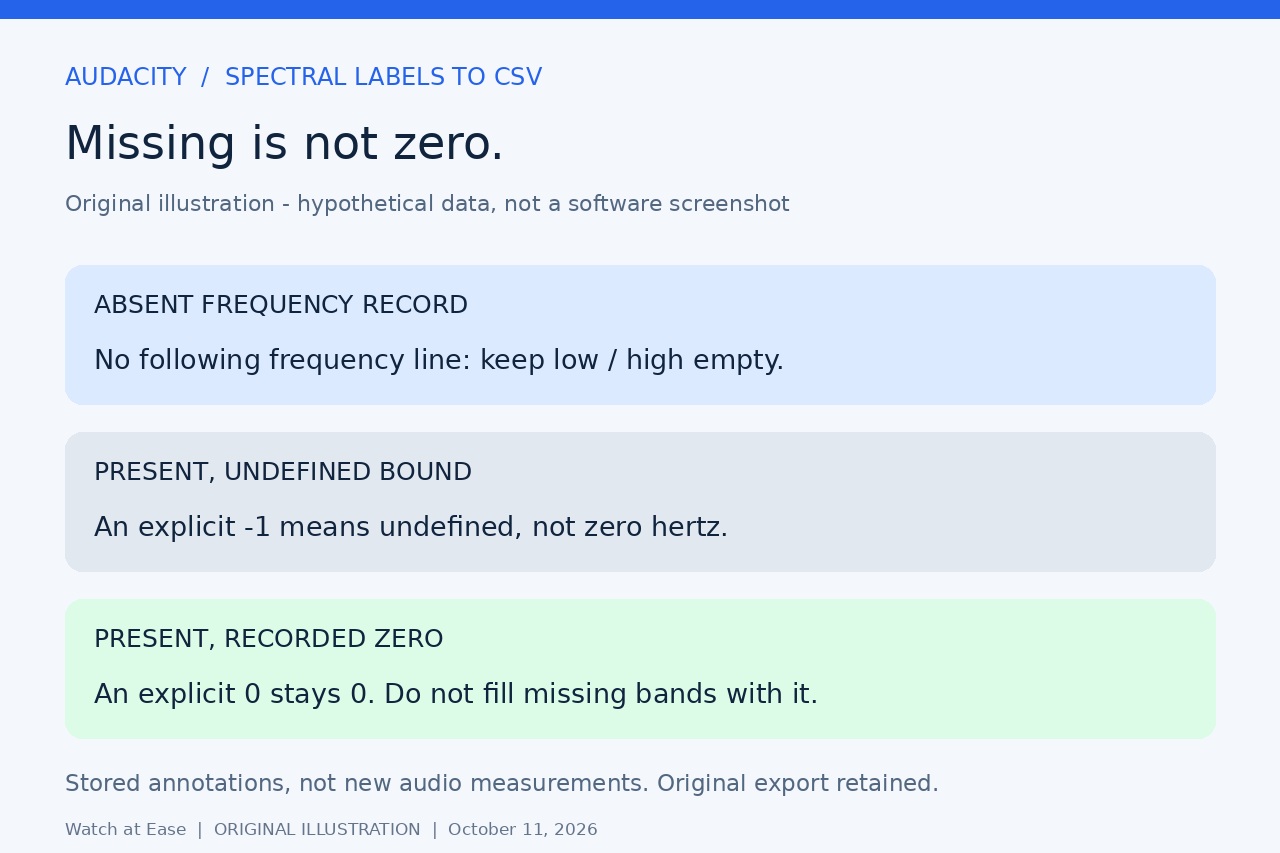
Que no siga una línea de frecuencia no significa cero hercios. Puede deberse al estilo estándar o a que no se guardó un rango. En el formato extendido documentado, -1 significa límite indefinido. Comprueba la etiqueta original y vuelve a exportar si hace falta; convertir no deduce un rango ausente ni reconstruye nombres de pista que el texto no contiene.
Convierte una copia compatible con Python 3
La receta acepta dos campos de segundos inicial/final no negativos separados por tabuladores, texto opcional y como máximo una línea de frecuencia inmediatamente después. Admite números con punto decimal, frecuencias finitas no negativas o el marcador indefinido -1. Etiquetas de tiempo negativo, decimales con coma, registros vacíos, campos tabulados extra y futuras continuaciones quedan fuera y detienen el proceso antes de crear salida.
En una terminal Bash de Linux con Python 3, entra en la carpeta de tu copia labels.txt. Copia el comando en una sola línea, conservando comillas rectas y barras inversas. Mantén el nombre de entrada y elige una salida nueva; rechaza labels.csv si ya existe. Probamos este comando exacto en Linux Bash, no en Windows ni macOS.
python3 -c 'exec('"'"'import csv\nfrom decimal import Decimal\nimport pathlib\nimport re\nimport sys\n\ndef number(text, minimum):\n if not re.fullmatch(r"[+-]?[0-9]+(?:\\.[0-9]*)?(?:[eE][+-]?[0-9]+)?", text):\n raise ValueError("Expected an unpadded dot-decimal number")\n value = Decimal(text)\n if not value.is_finite() or value < minimum:\n raise ValueError("Unsupported numerical value")\n return value\n\nrows = []\nraw = pathlib.Path(sys.argv[1]).read_text(encoding="utf-8-sig")\nlines = raw.split("\\n")\nif lines[-1] == "":\n lines.pop()\nfor line in lines:\n fields = line.split("\\t")\n if fields[0] == "\\\\":\n if len(fields) != 3 or not rows or rows[-1][-1] != "absent":\n raise ValueError("Orphan, repeated or unsupported frequency line")\n low, high = [number(text, Decimal(-1)) for text in fields[1:]]\n if any(value < 0 and value != -1 for value in [low, high]):\n raise ValueError("Negative frequency must be the undefined -1 sentinel")\n if low >= 0 and high >= 0 and low > high:\n raise ValueError("Reversed frequency bounds")\n rows[-1][4:] = [fields[1], fields[2], "present"]\n else:\n if len(fields) not in [2, 3]:\n raise ValueError("Expected two times and optional label, tab separated")\n start, end = [number(text, Decimal(0)) for text in fields[:2]]\n if end < start:\n raise ValueError("Reversed time bounds")\n rows.append([str(len(rows) + 1), fields[0], fields[1], fields[2] if len(fields) == 3 else "", "", "", "absent"])\nif not rows:\n raise ValueError("No label records")\nheader = ["ordinal", "start_seconds", "end_seconds", "label", "low_hz", "high_hz", "frequency_record"]\nwith open(sys.argv[2], "x", encoding="utf-8-sig", newline="") as output:\n writer = csv.writer(output)\n writer.writerow(header)\n writer.writerows(rows)\nwith open(sys.argv[2], encoding="utf-8-sig", newline="") as output:\n if list(csv.reader(output)) != [header] + rows:\n raise ValueError("Readback differs; discard output and use a new name")\nprint(len(rows), "label records checked; missing frequency is not zero")\n'"'"')' "labels.txt" "labels.csv"
Lee las siete columnas sin cambiar su significado
Las columnas son ordinal, start_seconds, end_seconds, label, low_hz, high_hz y frequency_record. Ordinal empieza en 1 en el orden de entrada; no es el número de pista. Present significa que se analizó una línea de frecuencia real; absent deja vacías ambas celdas de frecuencia. Un -1 explícito conserva su texto original, sin convertirse en cero ni en un límite supuesto.
El conversor conserva texto, registros repetidos, orden y cadenas numéricas originales. Decimal solo valida límites: no redondea con coma flotante, calcula duraciones, ordena ni estima frecuencias. Las comillas CSV resuelven comas y comillas dobles en el texto. Relee la salida y compara cada campo con los registros analizados antes de anunciar éxito.
En LibreOffice Calc importa UTF-8, separador coma y comillas dobles rectas como delimitador de texto. Pon las siete columnas como Texto y desactiva Combinar delimitadores, Recortar espacios y Evaluar fórmulas. Activa Editar configuración de filtros si se oculta el diálogo. Conserva un CSV maestro intacto; calcula sobre otra copia y elige allí la configuración decimal apropiada.
Comprueba las parejas y rechaza resultados parciales
Compara el número de etiquetas anunciado con la exportación prevista, no con las líneas físicas: una continuación de frecuencia no es otra etiqueta. Revisa un punto, una región y un límite indefinido conocido. Inspecciona filas alrededor de rangos ausentes para evitar unir una frecuencia posterior a otra etiqueta. Al combinar pistas puede perderse su atribución antes de convertir; el CSV no la restaura.
Ejecutamos 23 casos sintéticos con el comando exacto: parejas punto/región, ausencia frente a cero, límites -1, cadenas numéricas largas, Unicode y puntuación, etiquetas vacías repetidas y UTF-8 BOM/CRLF. Los seis casos válidos también rechazaron escrituras repetidas sin cambiar la salida y mantuvieron intactos los bytes de entrada. No ejecutamos Audacity ni Calc, ni este comando en Windows/macOS.
Líneas de frecuencia erróneas o huérfanas, continuaciones repetidas, límites invertidos y registros incompatibles detienen la creación. Si falla la escritura o relectura, descarta el CSV parcial y repite con un nombre nuevo. Guarda el texto original para comparar. La tabla registra selecciones exportadas, no picos medidos, amplitudes, detecciones de especies ni exportaciones de audio completadas; el rango es una anotación guardada, no una nueva medición espectral.